Dois analistas, mesmo contrato, mesmo modelo, mesma manhã.
O primeiro escreveu: “Analise este contrato de alienação fiduciária.”
O segundo escreveu: “Você é advogado especializado em execução de garantias. Identifique riscos que comprometeriam a execução deste contrato em caso de inadimplência. Foque em vícios formais e inconsistências com a matrícula. Se não houver dados suficientes para uma conclusão, indique explicitamente.”
O primeiro recebeu resumo genérico de cláusulas. O segundo recebeu alerta sobre divergência entre descrição do imóvel e registro — divergência que, ignorada, teria comprometido a garantia inteira.
Mesmo modelo. Resultados incomparáveis.
A explicação convencional diria que o segundo analista escreveu um “prompt melhor”. Mas o que isso significa, exatamente?
O Que Este Texto É (e o Que Não É)
Não estou propondo nada que pesquisadores de NLP, arquitetos de sistemas ou praticantes de HCI não saibam. Task framing, instruction conditioning, role prompting, output steering — tudo isso existe há anos na literatura técnica.
O que proponho é uma síntese operacional: traduzir conceitos que a filosofia da linguagem formalizou há décadas e que a engenharia aplica intuitivamente em um framework acionável para quem opera IA em ambiente regulado.
Por quê? Porque “intuição de quem opera” não sobrevive a auditoria. E porque prompts, em escala, deixam de ser texto descartável e se tornam infraestrutura decisória — com todas as implicações de governança que isso acarreta.
O Paradoxo da Interface
Usamos linguagem natural — nosso instrumento mais sofisticado para comunicar intenção e nuance — para interagir com sistemas cujo funcionamento interno não podemos verificar como ‘compreensão’ em qualquer sentido robusto.
Modelos de linguagem operam sobre distribuições de probabilidade entre tokens. Quando produzem respostas que parecem compreensão, estão executando correspondência de padrões extraordinariamente sofisticada — sofisticada o suficiente para ser útil, sofisticada o suficiente para parecer compreensão genuína.
Para fins práticos, isso inverte a responsabilidade comunicativa. Não estamos conversando. Estamos construindo contextos que, quando processados, produzem outputs úteis. A pergunta não é “como me faço entender” — é “como construo um contexto que gera o resultado que preciso”.
Essa inversão é o núcleo do argumento. Engenharia de prompt não é sobre palavras. É sobre arquitetura de contexto.
Ferramenta 1: Jogos de Linguagem
Wittgenstein, nas Investigações Filosóficas, mostrou que significado não existe em abstrato — existe apenas no uso, dentro do que chamou de “jogos de linguagem”. Um jogo de linguagem é um sistema de regras que governa como palavras funcionam em contexto específico. ‘Fora’ em futebol opera sob regras diferentes de ‘fora’ em topologia.
Uso o conceito aqui como metáfora operacional, não como afirmação sobre cognição. O modelo não ‘reconhece’ jogos no sentido wittgensteiniano — não participa de práticas sociais. Mas o efeito prático é análogo: diferentes sinais no prompt ativam diferentes distribuições de padrões, como se o modelo estivesse operando sob regras diferentes. A metáfora captura esse efeito sem exigir compreensão plena.
Um modelo treinado em milhões de textos absorveu padrões de milhares de jogos: artigos científicos, petições jurídicas, manuais técnicos, conversas informais. Quando você escreve um prompt, está sinalizando — implícita ou explicitamente — qual jogo quer jogar. Se os sinais são claros, o modelo ativa os padrões correspondentes. Se são ambíguos, ele escolhe um — frequentemente não o que você tinha em mente.
O primeiro analista não sinalizou jogo nenhum. “Analise este contrato” cabe em dezenas de contextos. O modelo escolheu o mais genérico e executou bem. Fez o que foi pedido; o problema é que não foi pedido o que era necessário.
O segundo analista sinalizou o jogo através de quatro elementos que, juntos, eliminam a maior parte da ambiguidade.
Ferramenta 2: O Quadrante do Contexto
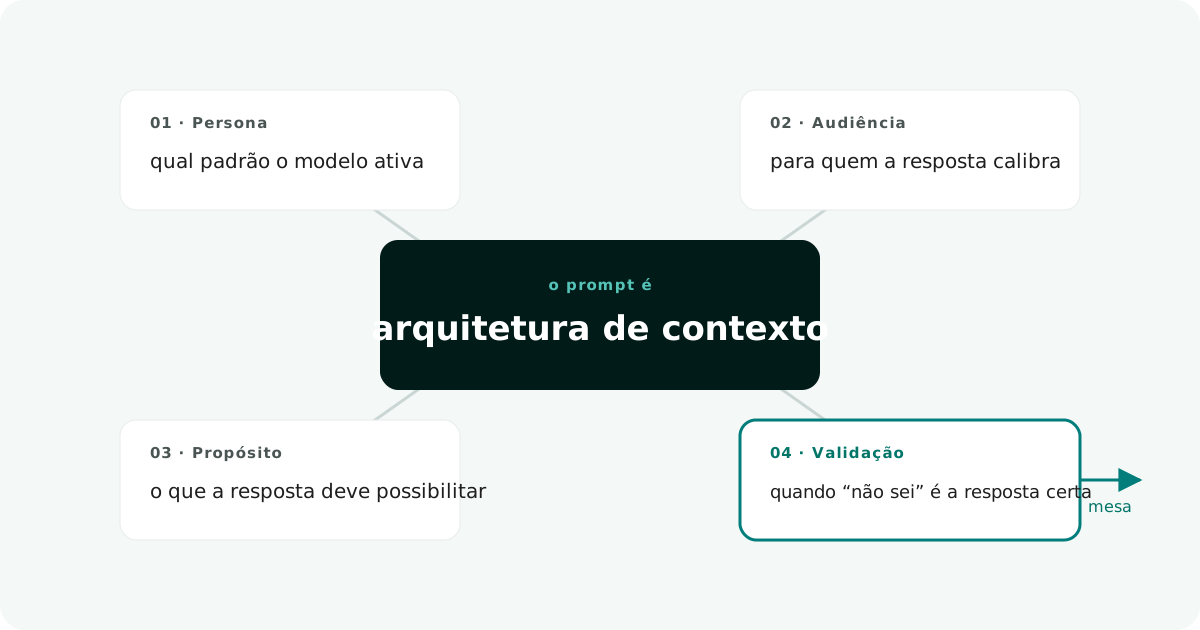
O segundo analista operou com quatro vértices: persona, audiência, propósito e validação.
Persona não é teatralização — é ativação de padrões. “Advogado especializado em execução de garantias” sinaliza vocabulário, nível de tecnicidade, tipos de risco relevantes. O modelo aprendeu essas diferenças em milhões de textos jurídicos. A persona seleciona qual subconjunto ativar.
Audiência calibra a resposta. Análise para comitê de crédito difere de análise para cliente pessoa física, mesmo sobre o mesmo contrato. Sem audiência explícita, o modelo assume audiência genérica — e calibra para ninguém em particular.
Propósito define o que a resposta deve possibilitar. Identificar riscos difere de propor soluções. Mapear opções difere de recomendar uma. Sem critério de sucesso explícito, o modelo otimiza para o critério mais genérico: parecer útil.
Validação fecha o ciclo decisório. Define como saber se a resposta cumpriu o propósito — e, crucialmente, quando “não sei” ou “não é possível determinar com os dados disponíveis” é a resposta correta. Em sistemas regulados, isso se traduz em limites de confiança, sinalização explícita de incerteza, classificação de risco do output. Sem critério de falha, o sistema não sabe quando escalar para julgamento humano.
O segundo analista definiu os quatro: persona de advogado de execução, audiência implícita de tomador de decisão sobre risco, propósito de identificar o que comprometeria a garantia, e validação explícita — “se não houver dados suficientes, indique”.
Quando qualquer vértice está indefinido, o modelo preenche com defaults (padrões). Defaults são, por definição, genéricos. E defaults de validação são os mais perigosos: o modelo quase nunca diz “não sei” espontaneamente.
Ferramenta 3: As Máximas de Grice
Dentro do jogo, regras de comunicação determinam se a informação atravessa a interface. Grice identificou máximas pragmáticas que governam comunicação cooperativa:
-
Quantidade: informação necessária, nem mais nem menos
-
Qualidade: não afirme o que acredita ser falso
-
Relevância: seja pertinente ao propósito
-
Modo: seja claro, ordenado, evite ambiguidade
Entre humanos, violações dessas máximas frequentemente geram significado adicional — ironia, implicatura, subtexto. Modelos não fazem essa inferência de forma confiável. Violação de máximas não gera significado oculto; gera ruído.
Omitir a modalidade de garantia (violação de quantidade) força o modelo a adivinhar. Incluir histórico irrelevante (violação de relevância) dilui atenção. Desorganizar documentos cronologicamente (violação de modo) confunde sequência de eventos.
Uma qualificação importante: Grice oferece checklist mínimo para evitar ruído, não teoria completa de emergência de significado. Implicaturas canceláveis, saliência contextual, background compartilhado — tudo isso opera na comunicação humana e está ausente ou degradado na interação com LLMs. O ponto é modesto: se você viola as máximas básicas, nem o mínimo funciona.
O Limite da Linguagem
Wittgenstein também mostrou que regras não determinam completamente sua aplicação. Qualquer regra pode ser interpretada de múltiplas formas. Em prompts, isso se manifesta como especificação incompleta: por mais detalhado que seja o contexto, sempre haverá casos não cobertos.
Pesquisas recentes (Hong et al., 2025) documentaram o fenômeno de context rot — a degradação de desempenho de LLMs à medida que o contexto aumenta. Zhang, Kraska e Khattab (2025), do MIT, demonstraram que essa degradação é sensível à complexidade da tarefa: tarefas exigindo processamento denso degradam mais rápido que tarefas com informação localizada, mesmo dentro da janela de contexto nominal do modelo.
O resultado alinha com o que praticantes observam em produção: prompts longos e mal estruturados falham de formas que prompts longos e bem estruturados não falham. A ciência ainda é incipiente, mas o princípio é robusto: estrutura importa tanto quanto tamanho.
Reconhecer esse limite não é pessimismo. É a base para arquitetar sistemas responsáveis — sistemas que sabem onde a automação alcança e onde o julgamento humano precisa entrar.
De Prática Individual a Governança Organizacional
Aqui está o ponto que a maioria dos guias de prompting ignora.
Quando você usa IA para tarefa pessoal, o prompt é descartável. Funcionou, ótimo. Não funcionou, ajusta e tenta de novo. Consequência: seu tempo.
Quando uma organização usa IA em processos de negócio, prompts passam a determinar como decisões são tomadas. Afetam clientes, parceiros, reguladores. Um prompt mal construído, replicado mil vezes por dia, não é inconveniente — é risco sistêmico.
Isso exige tratar prompts como infraestrutura:
-
Versionamento. Prompts em produção precisam de repositório controlado. Quem alterou, quando, por quê. Sem isso, não há como investigar quando algo falha.
-
Revisão. Mudanças em prompts críticos precisam de revisão antes de ir para produção — como código que afeta regras de negócio.
-
Testes. Conjunto representativo de casos contra os quais novos prompts são validados. Testes de regressão quando há alteração.
-
Trilha auditável. Em ambiente regulado, “o analista achou que funcionava” não é defesa. A trilha precisa mostrar o que foi usado, quando, com qual resultado.
-
Responsabilização. Quando o prompt produz decisão errada em escala, quem responde? Se a resposta não está clara antes do incidente, estará clara depois — da pior forma.
Prompts, em escala, são infraestrutura decisória. E infraestrutura decisória é objeto de governança, não de improviso.
Na GarantiaBR, a solução foi separar em duas camadas. A primeira — automatizada, com prompts altamente estruturados operando nos quatro vértices — resolve casos típicos com velocidade e consistência. A segunda — julgamento humano — entra quando o sistema sinaliza incerteza ou quando regras de domínio exigem revisão. O vértice de validação é o que conecta as duas camadas: define quando a automação deve parar e escalar.
Prompts funcionam como interface entre as camadas. Permitem que a automação seja agressiva, porque existe rede de segurança. E são tratados como infraestrutura: repositório versionado, revisão antes de produção, testes contra casos representativos.
O Contrato Implícito
Engenharia de prompt não é sobre escolher palavras certas. É sobre aceitar a assimetria fundamental: a responsabilidade pelo contexto é inteiramente sua.
É sobre construir estruturas — persona, audiência, propósito, validação — que eliminem ambiguidade antes que ela se torne erro. É sobre respeitar regras de comunicação que fazem informação atravessar a interface. É sobre reconhecer onde a linguagem alcança e onde ela falha, e arquitetar sistemas que lidem com ambos os casos.
Prompts não são conversa. São contratos implícitos entre intenção humana e processamento estatístico. Em escala, tornam-se infraestrutura decisória. E infraestrutura mal projetada não falha de forma espetacular — falha de forma silenciosa, consistente, difícil de atribuir.
Saber qual jogo está sendo jogado, sob quais regras, com quais limites, e quem responde quando o jogo produz consequências.
Isso é engenharia de prompt.
Referência:
Hong, K., Troynikov, A., & Huber, J. (2025). Context rot: How context degradation affects LLM performance. Chroma Research. https://research.trychroma.com/context-rot
Zhang, A. L., Kraska, T., & Khattab, O. (2025). Recursive Language Models. arXiv:2512.24601v1 (cs.AI). MIT CSAIL.
Publicado originalmente em ianapratica.substack.com.