Há um ruído ensurdecedor sobre “agentes de IA” neste momento.
Todo dia surge nova ferramenta, novo framework, nova promessa de que “agora sim” a automação vai funcionar. E duas reações dominam: entusiastas que acham que a ferramenta resolve tudo, céticos que acham que é mais uma moda.
Ambos estão errados. Não porque a verdade esteja no meio — essa é a resposta preguiçosa. Mas porque ambos confundem ferramenta com arquitetura.
O que está acontecendo de verdade é mais interessante: estamos descobrindo, em escala, que automação que escala é automação que valida a si mesma.
Não porque elimina o humano. Mas porque muda onde o humano entra.
O que o Clawdbot ensinou
Peter Steinberger construiu o PSPDFKit — framework de PDF usado em mais de um bilhão de dispositivos. Depois de vender a empresa e passar três anos longe da tecnologia, voltou em 2024 e mergulhou em desenvolvimento assistido por IA. Renomeado duas vezes por questões de marca — de Clawdbot para Moltbot, depois para OpenClaw — seu projeto pessoal se tornou o repositório de crescimento mais rápido da história do GitHub, superando 145 mil estrelas em semanas.
A frase que resume o que ele descobriu: “O segredo é fechar o loop. O agente precisa conseguir testar, validar e corrigir o próprio trabalho.”
Parece óbvio. Não é.
A maioria das implementações de IA opera no modelo “humano valida output”. O sistema gera, o humano confere, o sistema ajusta. É o modelo natural, intuitivo, e completamente errado para quem quer escalar.
Errado não porque supervisão humana seja ruim. Errado porque coloca o humano no lugar errado — validando cada output em vez de desenhando a arquitetura que valida.
O modelo que NÃO escala
Considere o fluxo típico: sistema gera output, humano revisa, humano aprova ou corrige, próximo caso.
Esse modelo tem um problema matemático. Se cada caso exige cinco minutos de revisão humana, e você processa mil casos por dia, você precisa de dezenas de horas-humanas diárias só para validação. Escalar volume significa escalar equipe na mesma proporção.
Mas o problema maior não é custo. É inconsistência.
Humanos cansam. Humanos têm vieses. Humanos interpretam critérios de forma diferente às 9h e às 17h. Quanto mais você depende de validação humana caso a caso, mais variância você introduz — exatamente o oposto do que automação deveria entregar.
O modelo que escala
O modelo alternativo inverte a posição do humano: sistema gera output, sistema valida, sistema corrige, sistema sinaliza exceções, humano supervisiona arquitetura.
A diferença é estrutural.
No primeiro modelo, o humano é gargalo operacional. Cada decisão passa por ele. No segundo modelo, o humano é arquiteto de validação. Define critérios, monitora exceções, refina regras. O volume de casos que exige atenção humana direta cai drasticamente — não porque você está aceitando mais risco, mas porque o sistema está absorvendo validação que antes era manual.
O que “fechar o loop” significa na prática
Na GarantiaBR, processamos documentos jurídicos e registrais para diferentes tipos de operações financeiras. Extraímos dados estruturados e transformamos em output decisório.
O desafio não é extrair dados. O desafio principal é saber quando a extração está errada. Porque em erro na concessão de um crédito, por exemplo, tem custo: conceder crédito indevido, negar crédito devido, interpretar mal uma cláusula crítica.
O modelo ingênuo: sistema extrai, humano valida tudo. Seguro, mas não escala.
O modelo perigoso: sistema extrai, humano valida amostra, assume que o resto está certo. Escala, mas acumula risco invisível.
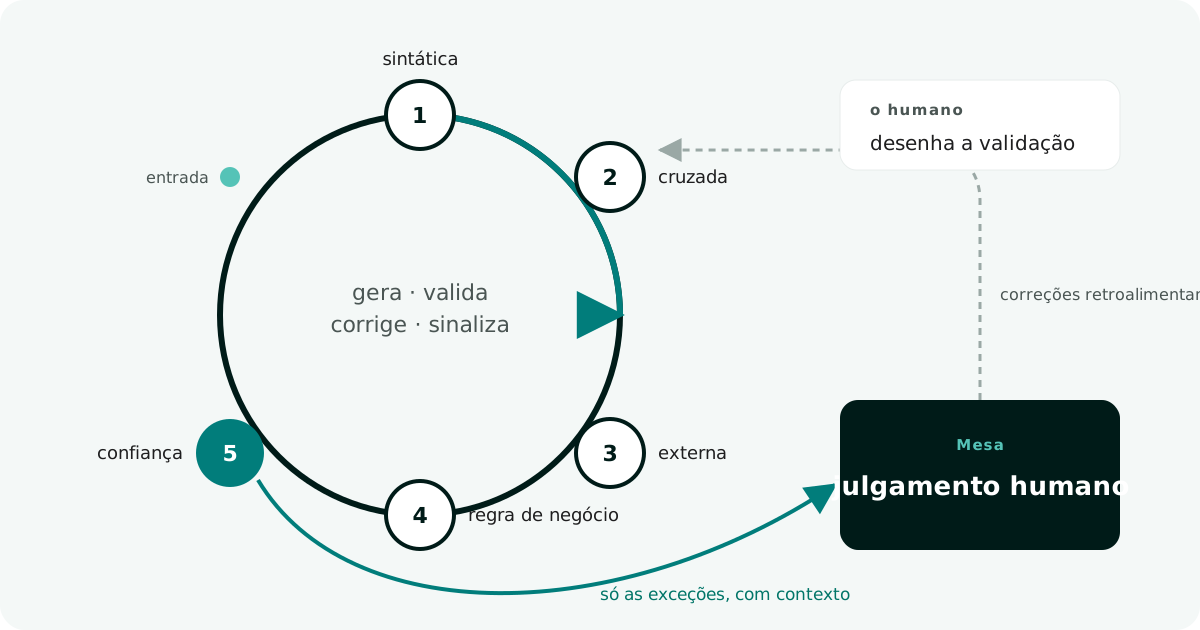
O modelo que funciona fecha o loop em camadas:
Camada 1 — Validação sintática. O dado extraído é estruturalmente válido? Os identificadores respeitam os formatos esperados? Os campos obrigatórios estão presentes?
Camada 2 — Validação cruzada. Os dados são consistentes entre si? Há contradições internas? As relações lógicas entre campos se sustentam?
Camada 3 — Validação externa. Os dados conferem com fontes autoritativas? Os registros existem nas bases oficiais? As informações extraídas correspondem à realidade documental?
Camada 4 — Validação de regra de negócio. Os dados satisfazem os requisitos específicos da operação? As condições de elegibilidade estão atendidas? Há impedimentos ou restrições aplicáveis?
Camada 5 — Cálculo de confiança. Dado o resultado das camadas anteriores, qual a probabilidade de a extração estar correta?
Casos acima do limite de confiança seguem fluxo automático. Casos abaixo escalam para humano. Correções humanas retroalimentam o sistema.
O objetivo arquitetural é que a maioria dos casos seja processada sem intervenção humana. Não porque ignoramos o risco — porque o sistema absorveu a validação.
E a aritmética confirma: se cada validação consome minutos e o volume cresce diariamente, a conta não fecha. No modelo com loop fechado, apenas a fração que excede o limite de confiança chega ao humano — e essa fração, quando a arquitetura é bem desenhada, tende a ser uma ordem de grandeza menor que o volume total.
Por que a ferramenta não importa
O projeto da OpenClaw, que demonstrou o poder de agentes autônomos, também se tornou a prova de que autonomia sem arquitetura de segurança é vulnerabilidade, tendo havido o vazamento de sua base de dados completa: API keys secretas, tokens de autenticação, dados de agentes de figuras públicas, etc..
A plataforma tinha a ferramenta. Não tinha a arquitetura. Ferramenta é commodity — intercambiável, substituível. Arquitetura de validação é vantagem competitiva — construída caso a caso, refinada com experiência, difícil de copiar.
Quem discute qual ferramenta é melhor está otimizando a variável errada.
Há uma crença implícita que freia organizações: a ideia de que existe trade-off entre velocidade e controle.
Se quero supervisão adequada, sacrifico eficiência. Se quero eficiência, aceito risco.
Essa crença é falsa — mas não da forma que você espera.
O trade-off real não é entre velocidade e controle. É entre clareza e confusão.
Sistema com arquitetura clara pode ser rápido e controlado simultaneamente. Sabe o que automatizar com confiança. Sabe o que escalar. Sabe onde supervisão humana agrega valor e onde é desperdício.
Sistema sem arquitetura clara é lento e descontrolado ao mesmo tempo. Não por ter supervisão demais ou de menos — por não saber distinguir um do outro.
A pergunta não é “quanto controle estou disposto a sacrificar por velocidade?” É “minha arquitetura é clara o suficiente para saber onde cada um importa?”
Os quatro requisitos
Para fechar o loop de verdade, quatro condições precisam existir:
1. Critérios objetivos de validação
Se você não consegue definir, antes de rodar o sistema, o que constitui output correto, você não está pronto para automatizar. “Eu sei quando vejo” não é critério — é ausência de critério.
Critério objetivo não significa critério simples. Pode ser sofisticado, condicional, dependente de contexto. Mas precisa ser articulável antes da execução, não apenas após.
2. Capacidade de auto-teste
O sistema precisa conseguir executar a validação contra seus próprios outputs. Isso exige que outputs sejam estruturados, que validações sejam programáveis, que o ciclo gerar-validar-corrigir seja automatizável.
Na prática: APIs em vez de interfaces opacas. Dados estruturados em vez de texto livre. Testes automatizados em vez de revisão visual.
Steinberger usa o conceito de “blast radius” — avaliar o raio de impacto de cada mudança antes de executar. Se algo demora mais do que o esperado, é sinal de que o escopo ou a complexidade foram subestimados. Esse raciocínio vale para qualquer sistema automatizado: entender o blast radius de cada decisão automatizada é pré-requisito para definir o nível de validação necessário.
3. Escalação com contexto
Quando o sistema escala para humano, precisa transferir contexto suficiente para que o humano entenda por que aquele caso específico exigiu atenção. “Baixa confiança” não é contexto. “Baixa confiança porque o campo X divergiu do esperado em Y%, e divergência acima do limite configurado dispara revisão” é contexto.
Escalação sem contexto transforma o humano em validador cego — exatamente o que é imprescindível evitar.
4. Ensaio de falha como rotina
Loop que só valida sucesso é loop incompleto. O sistema precisa ser testado contra cenários de falha — chaves comprometidas, APIs indisponíveis, dados corrompidos e fornecedores fora do ar — antes que aconteçam em produção.
Rotação periódica de credenciais. Simulação de indisponibilidade. Testes de recuperação. Não como evento extraordinário, mas como parte do ciclo operacional.
O ecossistema OpenClaw prova este ponto de forma dolorosa: pesquisadores encontraram mais de 900 instâncias expostas na internet com portas abertas e sem autenticação. Credenciais armazenadas em texto claro. Nenhum ensaio de falha foi feito antes de colocar o sistema em produção — e quando a falha veio, não havia recovery.
Quem só ensaia o caminho feliz descobre o caminho triste em produção.
O que isso exige de quem lidera
Fechar o loop não é projeto de tecnologia. É projeto de arquitetura organizacional.
Exige decidir, explicitamente, quais decisões podem ser automatizadas com confiança e quais exigem julgamento humano. Exige definir limites — não como intuição, mas como política documentada. Exige construir trilha auditável para que, quando algo der errado, você consiga reconstruir o que aconteceu e por quê.
Exige, em última instância, que liderança entenda que supervisão eficaz não é “olhar tudo”. É desenhar um sistema que sabe o que precisa ser olhado.
Isso é mais difícil do que parece. A tentação natural é ou automatizar tudo (e aceitar risco oculto) ou supervisionar tudo (e não escalar). A disciplina está em fazer a distinção caso a caso — e em construir arquitetura que operacionalize essa distinção.
Conclusão
O hype sobre agentes de IA vai passar. As ferramentas vão se consolidar, comoditizar, ser substituídas por outras.
O que vai permanecer é o princípio: automação que escala é automação que valida a si mesma.
Não porque elimina o humano. Mas porque posiciona o humano onde ele agrega valor — na arquitetura, na supervisão de exceções, no julgamento sobre casos que o sistema não consegue resolver sozinho.
O domínio não importa. O loop que fecha importa.
A pergunta que fica: sua automação fecha o loop, ou espera que humano feche para ela?
Publicado originalmente em ianapratica.substack.com.