Em janeiro de 2024, um sistema de análise de crédito recusou automaticamente a operação de um empresário com patrimônio líquido de R$ 12 milhões e histórico impecável de pagamentos. O motivo: score de crédito abaixo do threshold (limite aceito). O tempo de análise: oito segundos. O que o sistema não sabia — e não podia saber — é que o score refletia uma reestruturação societária recente, planejada por advogados tributaristas para otimização fiscal. A movimentação atípica nos últimos meses era sinal de sofisticação, não de risco. Mas para o algoritmo, atípico é atípico.
Ronald Dworkin passou a carreira tentando resolver um problema que parece simples à primeira vista: como juízes decidem casos difíceis? Sua resposta mudou a filosofia do direito e, sem que ele soubesse, tem implicações profundas para quem implementa sistemas de Inteligência Artificial.
Dworkin fez uma distinção que parece óbvia depois que você a entende, mas que é frequentemente ignorada na prática: regras são diferentes de princípios.
Regras operam no modo tudo-ou-nada. Quando uma regra se aplica, ela determina o resultado. “Velocidade máxima: 80 km/h” é uma regra. Você está abaixo ou está acima. Não há ponderação, não há “depende do contexto”. A beleza das regras está precisamente nessa clareza. Elas são previsíveis. Podem ser aplicadas por qualquer pessoa treinada — ou por qualquer algoritmo programado. São escaláveis.
Princípios funcionam de modo completamente diferente. Eles têm peso, não determinação absoluta. Podem conflitar entre si, e o conflito se resolve por ponderação, não por invalidação de um deles. “Ninguém pode se beneficiar da própria torpeza” é um princípio. Ele não determina sozinho o resultado de nenhum caso — precisa ser pesado contra outros princípios, considerando as circunstâncias específicas.
A diferença crucial é que princípios exigem julgamento. Não podem ser aplicados mecanicamente. Duas pessoas razoáveis podem ponderar de formas diferentes e ambas estarem justificadas.
Sistemas de inteligência artificial são, por natureza, máquinas de regras sofisticadas. Mesmo os mais avançados, que aprendem padrões complexos de milhões de exemplos, operam fundamentalmente no modo “se X, então Y”. Identificam padrões e os aplicam. Isso funciona extraordinariamente bem para casos típicos — onde regras são suficientes.
Mas casos atípicos frequentemente exigem princípios. Exigem olhar para aquele caso em sua singularidade e perguntar: a regra deveria se aplicar aqui? Há algum princípio que deveria prevalecer? Aquele empresário era um caso típico de score baixo, ou era uma exceção que demandava julgamento?
O sistema não faz essa pergunta. Aplica o padrão aprendido. E em oito segundos, uma decisão que merecia deliberação foi tratada como rotina.
Você poderia argumentar que a solução é simples: usar IA para casos típicos, humanos para atípicos. É uma resposta intuitiva, e contém verdade. Mas ela assume algo que raramente examinamos: que sabemos identificar quais casos são atípicos.
Aqui entramos em território mais traiçoeiro.
Para saber que um caso exige julgamento humano, o sistema precisaria saber que não sabe. Precisaria identificar seus próprios limites. Teria que realizar um meta-julgamento — um julgamento sobre os limites do próprio julgamento.
E aqui está o paradoxo que me intriga ao construir sistemas com Inteligência Artificial: para saber perfeitamente quando não sabe, o sistema precisaria, em certo sentido, saber tudo. Se conhecesse exatamente os limites do próprio conhecimento, saberia exatamente o que não sabe — e isso é uma forma de saber. Meta-julgamento perfeito é logicamente impossível.
O economista Frank Knight fez uma distinção que se tornou fundamental: risco é diferente de incerteza. No risco, você não sabe o que vai acontecer, mas conhece a distribuição de possibilidades — pode calcular probabilidades. Na incerteza genuína, você não sabe o que vai acontecer e não conhece a distribuição — não pode calcular porque não sabe quais são as possibilidades.
Mas a dicotomia de Knight, embora poderosa, é insuficiente para operacionalizar sistemas decisórios. Na prática, o “não saber” existe em gradações que exigem tratamentos distintos.
A incerteza paramétrica ocorre quando o modelo conhece a estrutura do problema, mas tem incerteza sobre parâmetros específicos. Um modelo de credit scoring sabe que renda afeta capacidade de pagamento, mas tem incerteza sobre o coeficiente exato para determinado segmento. Essa incerteza é tratável com intervalos de confiança — o sistema pode dizer “a probabilidade está entre X e Y” e escalar quando o intervalo é largo demais para decisão automática.
A incerteza estrutural emerge quando o próprio modelo pode estar mal especificado. Talvez a relação entre variáveis não seja linear como assumido. Talvez variáveis relevantes estejam ausentes. Essa incerteza é parcialmente tratável com ensembles — múltiplos modelos com estruturas diferentes. Quando divergem significativamente, há sinal de que a estrutura é incerta.
A incerteza fundamental surge quando o caso está fora da distribuição de treinamento. O sistema nunca viu nada parecido. Aqui, nenhuma técnica estatística resolve — o sistema está operando em território genuinamente desconhecido. Apenas escalação humana é apropriada.
Essa taxonomia não elimina o paradoxo epistemológico — o sistema ainda não pode saber perfeitamente quando está em incerteza fundamental. Mas permite calibração mais fina. Casos com incerteza apenas paramétrica podem ser automatizados com margens de segurança. Casos com incerteza estrutural exigem supervisão leve. Casos com sinais de incerteza fundamental exigem atenção humana real.
Mas há um limite incontornável: não é possível ter consciência completa sobre o que é desconhecido. O sistema não pode saber sobre os tipos de erro que nunca viu. Essa limitação não é técnica no sentido de que será resolvida com mais dados ou algoritmos melhores. É epistemológica. Está na natureza do que significa conhecer.
O que fazemos com isso? Como operamos sistemas sabendo que têm limites que nem eles mesmos conhecem?
A resposta que desenvolvemos na GarantiaBR é uma estrutura de camadas que tenta resolver — na medida do possível — a tensão entre regras e princípios.
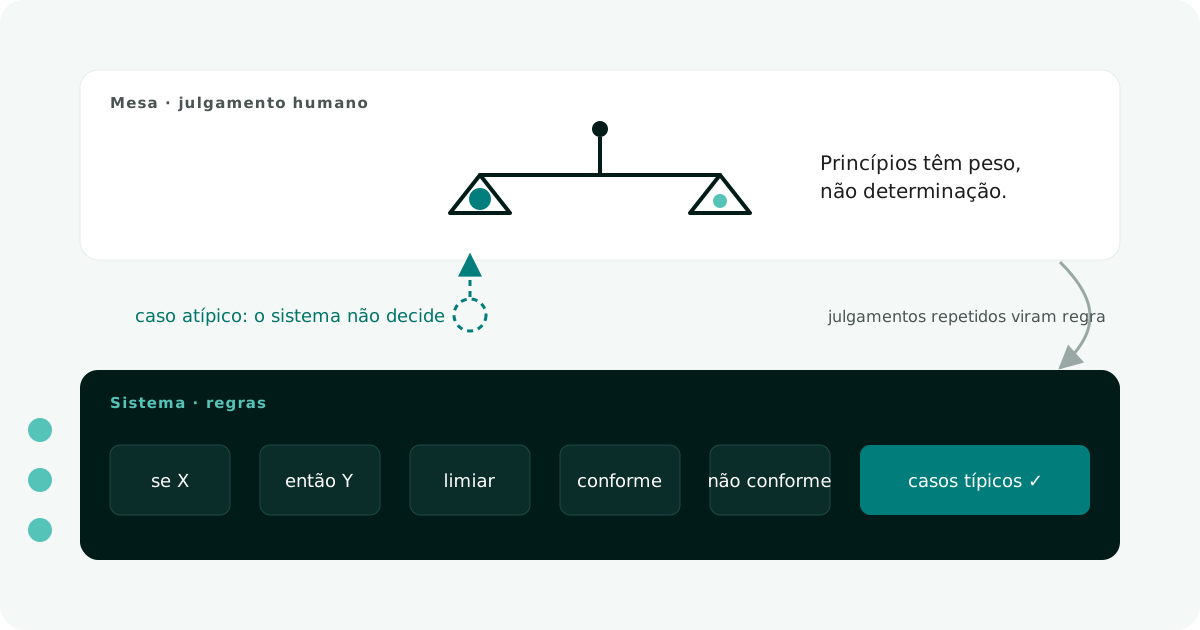
A primeira camada é o sistema. Opera por regras. Aprende padrões, aplica padrões. Faz isso muito bem para casos típicos. Mas o sistema também deve expressar graus de confiança calibrados ao tipo de incerteza, sinalizar quando um caso parece atípico, recusar decidir quando a incerteza é fundamental, e registrar cada decisão com rastreabilidade completa. Essa última parte — um sistema que às vezes diz “não sei” — parece menos capaz do que um que sempre responde. Na verdade, é mais honesto e mais seguro.
A segunda camada é o julgamento humano. Entra quando o sistema sinaliza incerteza estrutural ou fundamental, quando regras de domínio pré-definidas indicam necessidade, ou em supervisão amostral regular. O humano não apenas “aprova” — ele exerce julgamento. Pergunta se a regra deveria se aplicar. Considera princípios. Vê o caso em sua singularidade.
A calibração entre as camadas não é estática. Casos típicos com incerteza apenas paramétrica vão para automação. Casos com incerteza estrutural moderada recebem supervisão leve. Casos com sinais de incerteza fundamental recebem atenção humana real. Casos claramente fora de distribuição vão para especialistas, com o sistema servindo apenas como uma das fontes de informação.
Mas há um risco operacional que precisa ser endereçado: a escalação como recurso escasso.
Se o sistema escala demasiadamente para humanos — por cautela excessiva ou calibração imperfeita — dois efeitos degradantes emergem. O primeiro é a fadiga do revisor. Quando o volume de casos escalados excede a capacidade de atenção real, o humano começa a “aprovar mecanicamente”. A segunda camada, que deveria exercer julgamento, passa a operar como carimbo. O sistema de duas camadas colapsa em uma camada com ilusão de supervisão.
O segundo efeito é a degradação do aprendizado. Se o sistema escala casos que não precisavam de escalação, e o humano os aprova sem análise profunda, o feedback que retorna ao modelo é ruidoso. O sistema não aprende a distinguir genuína necessidade de escalação de falso positivo.
A solução é tratar escalação como recurso escasso e implementar aprendizado ativo. O sistema deve priorizar para revisão humana os casos mais informativos — aqueles onde a decisão humana tem maior potencial de melhorar o modelo. Isso significa, contraintuitivamente, escalar menos casos no total, mas escalar os casos certos.
Há ainda uma dimensão que frameworks estáticos ignoram: a fronteira entre regras e princípios evolui.
Casos que hoje exigem julgamento humano podem se tornar tipificáveis amanhã. Isso acontece quando acumulam precedentes suficientes, quando padrões emergem da repetição, quando o que era singular se revela categoria.
Considere um tipo de garantia imobiliária que inicialmente parecia atípico — talvez um imóvel rural com características incomuns de documentação. Os primeiros casos exigem julgamento humano real. Mas à medida que casos similares se acumulam, padrões emergem. O que era princípio (avaliar caso a caso) cristaliza-se em regra (se características A, B e C, então tratamento X).
Esse é o mecanismo pelo qual o sistema se torna progressivamente mais capaz sem perder segurança. A fronteira da automação avança, mas avança por acumulação de julgamentos humanos convertidos em regras — não por extrapolação do sistema além do que foi validado.
Implementar isso exige arquitetura específica. Cada decisão humana deve ser registrada com contexto suficiente para posterior análise. Periodicamente, o corpus de decisões humanas deve ser examinado para identificar padrões emergentes. Quando um padrão atinge massa crítica e consistência suficiente, pode ser proposto como nova regra — sujeita a validação antes de automação.
O sistema, assim, não é estático. É um organismo que aprende. Mas aprende de forma controlada, com humanos definindo quando padrões são robustos o suficiente para virarem regras.
Para instituições financeiras brasileiras, há uma dimensão adicional incontornável: compliance regulatório.
O Conselho Monetário Nacional (CMN) e o Banco Central (BCB) impõem requisitos específicos sobre sistemas automatizados de decisão. Não basta que o sistema funcione — é preciso demonstrar que funciona, como funciona, e que há governança adequada.
A arquitetura de duas camadas deve, portanto, gerar trilhas de auditoria que satisfaçam esses requisitos. Cada decisão automatizada precisa de registro que inclua os inputs utilizados, o racional do modelo (na medida do possível para modelos de caixa-preta), o nível de confiança expresso, e a classificação do tipo de incerteza.
Cada escalação para julgamento humano precisa de registro que inclua o motivo da escalação, a identidade do revisor, a decisão tomada, e a justificativa — especialmente quando diverge da sugestão do sistema.
Cada evolução do modelo — quando padrões humanos são convertidos em regras — precisa de registro que inclua a base de casos que fundamentou a nova regra, a validação realizada, a aprovação por instância competente, e o monitoramento pós-implementação.
Essa documentação não é burocracia. É a tradução de uma arquitetura decisória para a linguagem que reguladores compreendem e exigem. E é, também, proteção para a instituição — evidência de que decisões automatizadas estão sob governança adequada.
Dado que meta-julgamento perfeito é impossível, o princípio orientador que adotamos é simples de enunciar e difícil de implementar: assuma que você não sabe perfeitamente quando não sabe.
Isso implica um default para cautela. Na dúvida sobre se um caso exige julgamento humano, assuma que exige. O custo de escalar desnecessariamente é ineficiência. O custo de não escalar quando deveria é erro grave. Os custos são assimétricos, e a escolha racional é errar para o lado da escalação — mas com consciência de que escalação excessiva tem seus próprios custos.
Implica margem de segurança. Se o modelo sugere threshold X para automação, use X menos uma margem. A margem é seguro contra erros de calibração que você não consegue detectar.
Implica múltiplas linhas de defesa. Não confie em uma única forma de identificar casos que precisam de julgamento. Use sinalização de incerteza paramétrica, estrutural e fundamental. Use regras de domínio pré-definidas. Use supervisão amostral aleatória. Use feedback de resultados quando erros são descobertos.
Implica capacidade de exceção. O humano deve poder divergir do sistema. Mesmo quando o sistema está confiante. Especialmente quando o sistema está confiante mas algo parece errado.
Implica aprendizado controlado. O sistema deve evoluir, mas evoluir pela cristalização de julgamentos humanos em regras, não por extrapolação autônoma.
E implica rastreabilidade completa. Cada decisão, cada escalação, cada evolução deve ser documentada de forma que suporte tanto melhoria contínua quanto auditoria regulatória.
A tensão entre regras e princípios não será resolvida. É inerente à natureza de decisões complexas. Dworkin não a resolveu para o direito; nós não a resolveremos para IA.
O que podemos fazer é reconhecê-la explicitamente, estruturar processos que a gerenciem, implementar meta-julgamento calibrado por tipo de incerteza, manter a escalação como recurso escasso e precioso, permitir que a fronteira da automação evolua de forma controlada, garantir rastreabilidade que satisfaça exigências regulatórias, e preservar humildade permanente sobre os limites do que sistemas podem fazer.
Mais do que uma solução elegante, trata-se de uma solução honesta.
Publicado originalmente em ianapratica.substack.com.